Robots.txt Nedir? Komutlar ve Örnek Dosyalar
Robots.txt nedir, nasıl yazılır? Temel komutlar, Google'ın kuralları okuma sırası, yapay zekâ botları, sık hatalar ve WordPress, e-ticaret örnekleri.
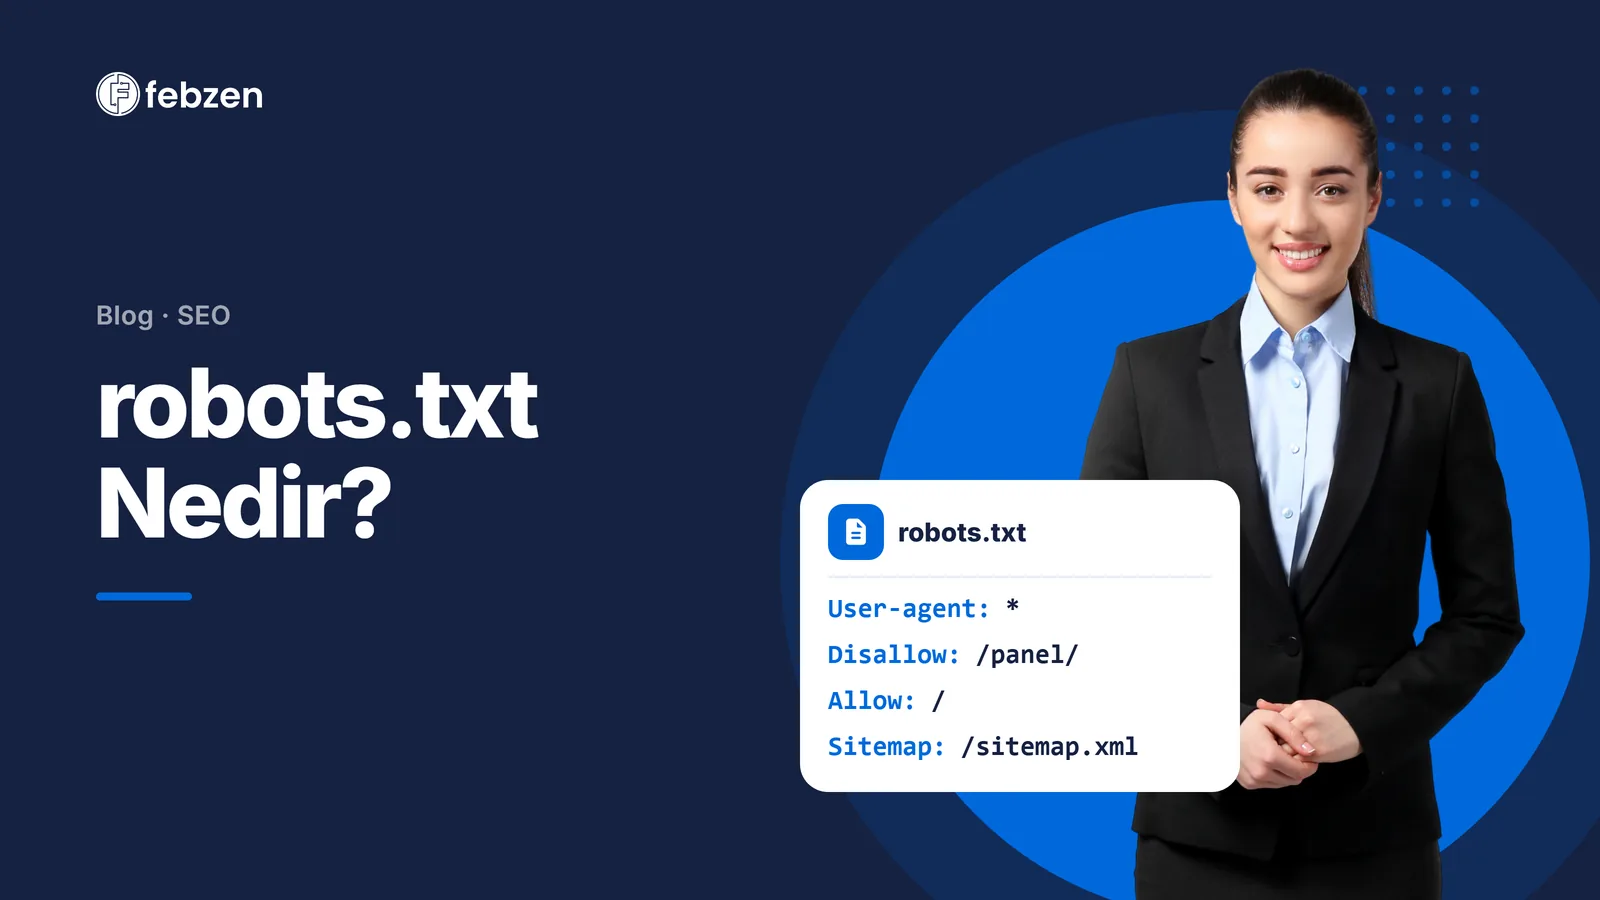
Robots.txt, sitenizin kök dizininde duran ve arama motoru botlarına hangi adresleri tarayıp hangilerini taramayacaklarını söyleyen düz metin dosyasıdır. Tarama kuralı koyar, indeksleme kuralı koymaz: bir sayfayı arama sonuçlarından çıkarmak için noindex gerekir. Google dosyada yalnız User-agent, Disallow, Allow ve Sitemap satırlarını dikkate alır.
Robots.txt nedir, ne işe yarar?
Bir siteyi yalnızca insanlar ziyaret etmez. Google, Bing ve Yandex'in tarayıcı (crawler) botları, son yıllarda da yapay zekâ şirketlerinin botları sayfaları düzenli olarak dolaşır. Robots.txt bu botlara sitenizin hangi bölümlerine girmelerini, hangilerine girmemelerini istediğinizi bildirir.
Kurallar bağlayıcı değildir. Google, Bing ve büyük yapay zekâ şirketlerinin botları uyar; kötü niyetli botlar dosyayı yok sayabilir. Yanlış yazılmış tek bir satır (ör. Disallow: /) sitenin tamamının taranmasını durdurabilir. Bu yüzden dosya kısa olsa da dikkatle yazılmalıdır.
Neden robots.txt kullanılır? 3 temel neden
1. Tarama bütçesini doğru yere harcamak
Google her site için belirli bir tarama kapasitesi ayırır. Botlar yönetim paneli, sepet ya da sınırsız sayıda üretilen filtre sayfalarında vakit harcarsa yeni yazılarınıza ve ürünlerinize sıra geç gelebilir. Google'a göre tarama bütçesi asıl olarak çok sayıda sayfası olan büyük sitelerde önem taşır; birkaç yüz sayfalık bir sitede çoğu zaman sorun olmaz.
2. Taranmasını istemediğiniz alanları ayırmak
Yönetim paneli (/wp-admin/), hazırlık ortamı (/staging/) ya da iç arama sonuçları gibi alanların taranmasına gerek yoktur. Robots.txt bunu bildirir, ancak bir güvenlik önlemi değildir: dosya herkese açıktır ve içinde yazdığınız yollar da okunabilir. Gizli kalması gereken alanları parola veya oturumla koruyun; arama sonuçlarında görünmemesi gereken sayfalara noindex ekleyin.
3. Sunucu yükünü azaltmak
Bazı botlar kısa sürede çok sayıda istek gönderir. Crawl-delay satırı Bing ve Anthropic'in ClaudeBot'u gibi bazı botlara istekler arasında beklemesini söyler; Google bu satırı yok sayar. Kurallara uymayan botları robots.txt durdurmaz; onları güvenlik duvarı, hız sınırlama ya da Cloudflare kurallarıyla sunucuya ulaşmadan engellemek gerekir.
Febzen ipucu: Gereksiz bot taramalarını azaltmak, sunucu kaynaklarını gerçek ziyaretçilerinize bırakır. Özellikle filtre ve arama sayfası çok olan sitelerde botların ürettiği istekler işlemci kullanımında belirgin bir pay tutabilir.
Robots.txt dosyası nerede olmalı?
- Konum: Dosya alan adının kökünde ve tam olarak
robots.txtadıyla durmalıdır:https://siteniz.com/robots.txt. Alt klasöre konan dosya (/blog/robots.txt) okunmaz. - Kapsam: Kurallar yalnız dosyanın bulunduğu protokol, alan adı ve port için geçerlidir.
blog.siteniz.com,shop.siteniz.comgibi her alt alan adının kendi robots.txt dosyası olmalıdır. - Biçim: Dosya UTF-8 kodlu düz metin olmalıdır. Google en fazla 500 KiB okur; sınırın ötesindeki satırlar dikkate alınmaz.
- Güncelleme süresi: Google dosyayı genelde 24 saate kadar önbellekte tutar. Yaptığınız değişiklik hemen değil, birkaç saat ile bir gün içinde etkili olur.
Temel komutlar ve söz dizimi
User-agent: *
Disallow: /admin/
Allow: /admin/images/

Sitemap: https://siteniz.com/sitemap.xml
User-agent: *→ Altındaki kurallar tüm botlar için geçerlidir. Belirli bir bot için o botun adını yazarsınız (User-agent: Googlebot).Disallow: /admin/→/admin/ile başlayan adreslerin taranmasını engeller. Boş bırakılanDisallow:satırı "her şey serbest" demektir.Allow: /admin/images/→ Engellenen klasörün içindeki bu yolun taranmasına izin verir.Sitemap:→ Site haritasının tam adresini (https://ile) bildirir. Bir gruba bağlı değildir; dosyanın herhangi bir yerine yazılabilir ve birden fazla site haritası eklenebilir.
Yollar her zaman / ile başlar ve büyük/küçük harfe duyarlıdır: Disallow: /Dosya/ kuralı /dosya/ klasörünü engellemez.
Joker karakterler
*→ Herhangi bir karakter dizisinin yerini tutar.Disallow: /*.pdfadresinde.pdfgeçen tüm URL'leri engeller.$→ Adresin sonunu belirtir.Disallow: /*.pdf$yalnız.pdfile biten adresleri engeller;/rapor.pdf?sayfa=2gibi parametreli adresler bu kurala takılmaz.
Google kuralları hangi sırayla okur?
Dosya uzadıkça satırların birbirini nasıl etkilediği önem kazanır. Google'ın belgelediği üç kural:
1. Her bot yalnız kendine en uygun grubu okur. Bir bot için ayrı grup yazdıysanız o bot User-agent: * grubunu tamamen yok sayar; * grubu ile özel grup birleştirilmez. Aynı bot adına yazılmış birden fazla grup ise tek grup gibi birleştirilir.
User-agent: *
Disallow: /yonetim/

User-agent: Googlebot
Disallow: /arama/
Bu dosyada Googlebot yalnız /arama/ kuralını uygular, /yonetim/ onun için açıktır. Googlebot'un da /yonetim/ adresine girmemesini istiyorsanız o satırı Googlebot grubuna da yazmanız gerekir.
2. En uzun (en belirgin) yol kazanır. Aynı adrese hem Allow hem Disallow uyuyorsa yolu daha uzun olan kural uygulanır. Uzunluklar eşitse Google daha az kısıtlayan kuralı, yani Allow'u seçer.
User-agent: *
Disallow: /blog/
Allow: /blog/rehberler/
/blog/rehberler/vds-kurulumu taranır, /blog/kategori/haberler taranmaz.
3. Sunucunun verdiği yanıt da bir kuraldır.
| robots.txt adresi ne döndürüyor? | Google ne yapar? |
|---|---|
| 200 | Dosyadaki kuralları uygular |
| 4xx (404, 403 vb.; 429 hariç) | Dosya yokmuş gibi davranır, tüm siteyi tarayabilir |
| 5xx ya da zaman aşımı | İlk 12 saat siteyi taramayı durdurur; 30 güne kadar dosyanın son başarılı kopyasını kullanır. Önbellekte kopya yoksa kısıtlama yokmuş gibi davranır; 30 günün sonunda site genel olarak erişilebiliyorsa robots.txt yokmuş gibi tarar |
5xx davranışı önemlidir: robots.txt adresi hata verirse Google o süre içinde sitenin geri kalanını da taramaz. Dosyanın her zaman 200 döndüğünü kontrol edin.
Google'ın desteklemediği kurallar
Crawl-delay→ Google yok sayar. Googlebot'un tarama hızını sunucunun yanıt süresine ve hata oranına göre kendisi ayarlar.Noindex,Nofollow→ Robots.txt içinde Google için geçersizdir. Google 2019'dan beri bu satırları dikkate almaz. Sayfayı dizinden çıkarmak için sayfanın kendisinde<meta name="robots" content="noindex">ya daX-Robots-Tag: noindexbaşlığı kullanılır.Host→ Yandex'in eski bir yönergesidir; Google için anlamı yoktur.
Yapay zekâ botları ve robots.txt
Yapay zekâ şirketleri artık amaca göre ayrı botlar kullanıyor: modeli eğitmek için tarayan botlar, yapay zekâ aramasında sitenizi kaynak olarak gösteren botlar ve bir kullanıcı sorduğunda tek bir sayfayı açan botlar. Robots.txt ile bunları ayrı ayrı yönetebilirsiniz.
| User-agent | Firma | Ne yapar? | Robots.txt'ye uyar mı? |
|---|---|---|---|
GPTBot |
OpenAI | Model eğitimi için tarar | Uyar |
OAI-SearchBot |
OpenAI | ChatGPT aramasında siteleri gösterir | Uyar |
ChatGPT-User |
OpenAI | Kullanıcı istediğinde sayfayı açar | OpenAI'ye göre kurallar uygulanmayabilir |
ClaudeBot |
Anthropic | Model eğitimi için tarar | Uyar; Crawl-delay satırını da dikkate alır |
Claude-SearchBot |
Anthropic | Claude'un arama yanıtları için tarar | Uyar |
Claude-User |
Anthropic | Kullanıcı istediğinde sayfayı açar | Anthropic'e göre genellikle uyar |
PerplexityBot |
Perplexity | Perplexity arama sonuçlarında siteleri gösterir; model eğitimi için kullanılmaz | Uyar |
Perplexity-User |
Perplexity | Kullanıcı istediğinde sayfayı açar | Perplexity'ye göre genellikle uymaz |
Google-Extended |
Ayrı bir bot değildir. Google'ın taradığı içeriğin Gemini modellerinin eğitiminde ve yanıtlarında kullanılıp kullanılmayacağını belirler | Uyar; Google Arama'daki görünürlüğü ve sıralamayı etkilemez |
Kaynak: OpenAI, Anthropic, Perplexity ve Google'ın resmi tarayıcı belgeleri (Kasım 2026). Botların adları ve davranışları değişebildiği için dosyanızı yılda en az bir kez bu belgelerle karşılaştırın.
Örnek: İçeriğin model eğitiminde kullanılmasını istemeyen ama yapay zekâ aramalarında görünmeye devam etmek isteyen bir site:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: *
Disallow:

Sitemap: https://siteniz.com/sitemap.xml
Google-Extended'i engellemek Google Arama'yı etkilemez, ama içeriğiniz Gemini uygulamalarının yanıtlarında da kaynak olarak kullanılmaz. Gemini yanıtlarında görünmek istiyorsanız bu grubu çıkarın.
Bu bir tercih meselesidir; doğru ya da yanlış tek bir ayar yoktur. Dikkat edilecek üç nokta:
OAI-SearchBot,Claude-SearchBotya daPerplexityBot'u engellerseniz siteniz o servislerin arama yanıtlarında kaynak olarak görünmeyebilir.- Kullanıcı isteğiyle çalışan botlar (
ChatGPT-User,Perplexity-User) robots.txt'ye her zaman uymaz. Kesin engel gerekiyorsa sunucu ya da CDN tarafında kural yazılır. - Cloudflare gibi servislerin "yapay zekâ botlarını engelle" ayarı robots.txt'den bağımsız çalışır. Robots.txt'de izin verdiğiniz bir bot CDN'de engellenmiş olabilir; ikisini birlikte kontrol edin.
En sık yapılan 6 robots.txt hatası
- Tüm siteyi engellemek: Geliştirme sırasında yazılan
Disallow: /satırını yayına geçerken kaldırmayı unutmak. Google siteyi tarayamaz; sayfalar zamanla sonuçlardan düşer ya da açıklamasız görünür. - CSS ve JavaScript dosyalarını engellemek: Google sayfayı bir tarayıcı gibi oluşturur (render). Bu dosyalar engellenirse sayfayı eksik görür ve içeriği eksik değerlendirebilir.
- Robots.txt'yi noindex yerine kullanmak: Robots.txt ile engellenen bir sayfa, başka sitelerden bağlantı alıyorsa içeriği olmadan, yalnız adresiyle sonuçlarda çıkabilir. Sayfayı dizinden çıkarmak için
noindexkullanın ve o sayfayı robots.txt ile engellemeyin; engellerseniz Googlenoindexetiketini hiç göremez. - Bot grubu yazınca genel kuralları unutmak: Googlebot için ayrı grup açtığınızda
User-agent: *altındaki kurallar Googlebot için geçersiz olur. Ortak kuralları her gruba ayrıca yazın. - Site haritasını göreli yazmak:
Sitemap: /sitemap.xmlyerine tam adres yazın:Sitemap: https://siteniz.com/sitemap.xml. - Büyük/küçük harfi karıştırmak:
Disallow: /Dosya/kuralı/dosya/klasörünü engellemez; yolları sitenizdeki adresle birebir aynı yazın.
WordPress ve e-ticaret siteleri için örnek dosyalar
WordPress için temel robots.txt
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://siteniz.com/sitemap_index.xml
- Site haritası adresi:
sitemap_index.xml, Yoast SEO ve Rank Math eklentilerinin site haritası adresidir. SEO eklentisi kullanmıyorsanız WordPress'in kendi site haritası/wp-sitemap.xmladresindedir. - Eklenti klasörü:
/wp-content/plugins/klasörünü engellemeyin. Eklentilerin CSS ve JavaScript dosyaları buradadır ve Google'ın sayfayı doğru oluşturması için gereklidir. - Dosyayı oluşturma: Kendi robots.txt dosyanızı SEO eklentinizin dosya düzenleyicisiyle oluşturabilir ya da cPanel veya Plesk'teki Dosya Yöneticisi'nde sitenizin kök klasörüne (cPanel'de
public_html)robots.txtadıyla yükleyebilirsiniz. Ardındanhttps://alanadiniz.com/robots.txtadresini açarak içeriği kontrol edin. - Barındırma: WordPress siteniz için WordPress hosting paketlerimize göz atabilirsiniz.
WooCommerce için öneri
E-ticaret sitelerinde sıralama ve filtre seçenekleri (renk, beden, fiyat aralığı) birbiriyle birleşerek çok sayıda adres üretir. Bu adreslerin taranması, tarama kapasitesini ürün sayfaları yerine kopya listelere harcatabilir.
User-agent: *
Disallow: /sepet/
Disallow: /odeme/
Disallow: /hesabim/
Disallow: /*?*orderby=
Disallow: /*?*filter_
Disallow: /*?*min_price=
Disallow: /*?*add-to-cart=

Sitemap: https://siteniz.com/sitemap_index.xml
- Sayfa adresleri:
/sepet/,/odeme/ve/hesabim/, WooCommerce'in Türkçe kurulumda genellikle kullandığı varsayılan adreslerdir. Sitenizde farklıysa kendi adreslerinizi yazın. - Parametre kuralları:
/*?*orderby=biçimi, parametre adreste kaçıncı sırada olursa olsun eşleşir./*?filterbiçimi yalnız soru işaretinden hemen sonra gelen parametreyi yakalar.
OpenCart için öneri
OpenCart sayfaları route= parametresiyle çalışır:
User-agent: *
Disallow: /*route=checkout/
Disallow: /*route=account/
Disallow: /*route=product/search
Disallow: /*?*sort=
Disallow: /*?*limit=

Sitemap: https://siteniz.com/sitemap.xml
Filtre adreslerini robots.txt ile kapatmak, Google'ın o adreslerdeki canonical etiketini görmesini de engeller. Filtre sayfalarından bazılarının (ör. "kırmızı elbise") aramada çıkmasını istiyorsanız onları engellemeyin; yalnız gereksiz kombinasyonları kapatın.
Robots.txt nasıl test edilir?
- Tarayıcıda açın:
https://siteniz.com/robots.txtadresi 200 dönmeli ve düz metin olarak açılmalıdır. -
Search Console robots.txt raporunu kullanın: Ayarlar sayfasındaki raporda şunlar görünür:
- Google'ın dosyayı en son ne zaman aldığı
- Hangi satırları geçersiz saydığı
- Alt alan adlarınızın dosyaları
Değişiklik yaptıktan sonra aynı rapordan yeniden tarama isteyebilirsiniz.
-
URL Denetimi aracıyla deneyin: Engellemediğinizden emin olmak istediğiniz önemli sayfaları bu araçla kontrol edin. Sayfa engelliyse araç bunu "robots.txt tarafından engellendi" diye gösterir.
Sunucu altyapısı ve tarama hızı
Robots.txt botların neyi tarayacağını belirler. Ne kadar hızlı tarayacaklarını ise büyük ölçüde sunucunuz belirler. Google, sunucu hızlı ve hatasız yanıt verdiğinde tarama hızını artırır; yavaşlama ya da 5xx hatalarında azaltır. Doğru yazılmış bir robots.txt gereksiz yükü azaltır, ancak yüksek trafikli bir sitede tek başına yeterli değildir.
Siteniz bot taramaları sırasında yavaşlıyorsa yapılabilecekler:
- Kaynakları size ayrılmış sunucuya geçmek: VDS sunucu, NVMe diskli Ryzen VDS ya da fiziksel sunucu seçeneklerimize göz atabilirsiniz.
- Küçük ve orta ölçekli siteler için: Web hosting paketleri çoğu zaman yeterlidir.
Ayrıntılı kurallar ve örnekler için Google Arama Merkezi'nin robots.txt belgelerine bakabilirsiniz.
Sık sorulan sorular
Robots.txt olmazsa ne olur?
Dosya yoksa ya da adres 404 dönüyorsa Google sitenin tamamını tarayabileceğini varsayar. Küçük siteler için bu sorun değildir; yine de Sitemap satırını bildirmek için basit bir dosya önerilir.
Robots.txt değişikliği ne zaman etkili olur?
Google dosyayı genelde 24 saate kadar önbellekte tutar. Search Console'daki robots.txt raporundan yeniden tarama isteyerek süreyi kısaltabilirsiniz.
Robots.txt sayfayı Google'dan siler mi?
Hayır. Tarama engellenir ama sayfa adresi sonuçlarda kalabilir. Silmek için noindex ya da Search Console'daki Kaldırma aracı kullanılır.
Siteniz için hosting. robots.txt dosyasını cPanel hosting paketlerinde Dosya Yöneticisi ile sitenizin kök dizinine yükleyebilirsiniz.